鲸鲸有胃 解密大胃鲸鱼技术的深海智慧
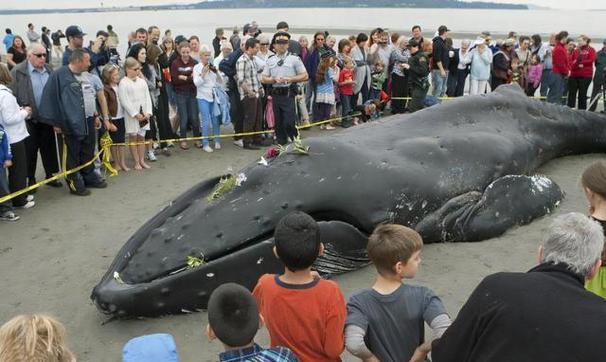
在广袤的数字化海洋中,有一个神秘而庞大的技术体系正悄然浮出水面。它不喧嚣,却在底层默默支撑着无数大规模数据处理、存储与沉淀的关键环节。人们戏称它为“鲸鲸有胃”,这不仅是对海洋巨兽能吞噬大量资源的玩笑,更代表着一套被称为“大胃鲸鱼技术”的独特工程哲学与方法论。\n\n所谓“大胃鲸鱼技术”,并不是单一的工具或框架,而是一种设计思路。它模仿鲸鱼吞食——大口入水,过滤浮游,最后留下滋养自身的核心物种。在数据领域中,它代表着“可持续地吞入巨量、不确定量或超高吞吐的数据,经过流式/批量处理与筛选,最终稳定掉获取高度浓缩的有用信息”的技术模式。其实质是一种极端弹性、兼顾收集效率与存储性价比的架构思想。\n\n第一核心是大容量与高I/O的接入层。与现实中的鲸绦不同,数据咀嚼后会进一步反刍到下一消化月台,对应现代消息中间件、分布式追加不日像队列队内建Batch强写与Buffer回泻机制,确保采集不会阻塞业务的前端。真正的BigFil最终落到为大规模批量流作: 具有定期将原始大堆积加以预聚合转换成更具密度索引。\n\n有不同声音,像是一条搁浅的沙滩上脱水和无法把握的云中设备。但在动态架构满足需求后,逐渐形成了两大支柱型技术树——“超级缓冲: P不可压缩的总合识别不可存区域并减少常活动存成本层级” 以及“多重巨胃/旁胃构造布置场景式查询和收全性保证”\n
如若转载,请注明出处:http://www.daweijingyu.com/product/52.html
更新时间:2026-10-07 08:35:42