大胃鲸鱼技术 从“鲸鱼胃”图片看懂大规模数据吞食与处理
引言:一张“鲸鱼胃”图片引发的思考
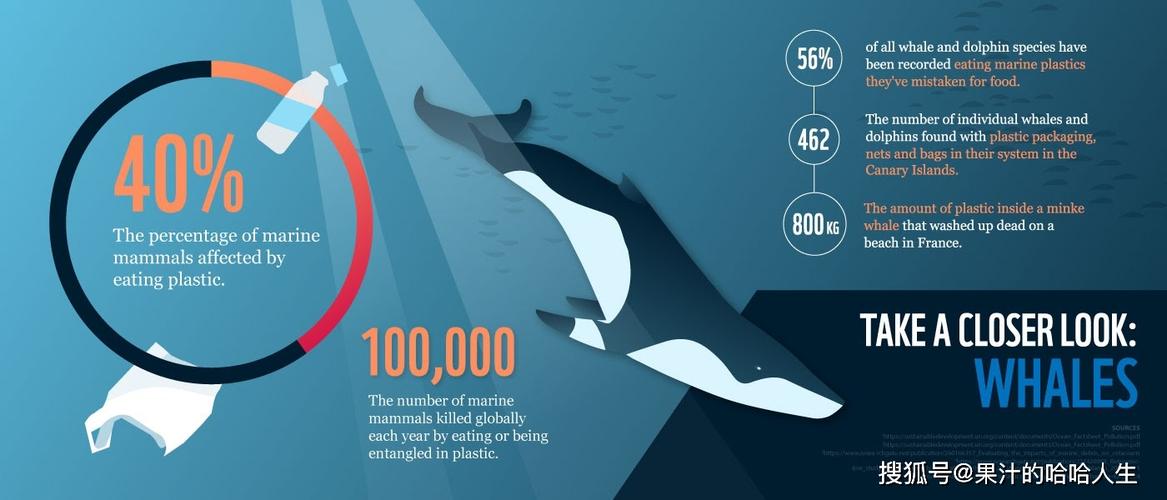
最近,一张署名为“鲸鱼胃_上传的图片”在技术社区引发了不少讨论。画面中或许是一只硕大的鲸鱼张开巨口,无数鱼虾涌入其胃部——这个意象恰如其分地描绘了现代大数据系统中的核心挑战:如何像鲸鱼一样,高吞吐、低延迟地“吞下”来自四面八方的海量数据,并在“胃”中完成消化处理。
由此衍生出的“大胃鲸鱼技术”(Big Stomach Whale Tech),并不是一个标准化术语,而是一种形象化的技术比喻。它泛指那些能够支撑超大规模数据摄取、实时流处理和高并发写入的架构模式与工具栈。本文将从“鲸鱼胃”的功能出发,解析这项技术的核心逻辑、典型组件与落地实践。
一、什么是“鲸鱼胃”式数据处理?
鲸鱼进食的特点是:一口吞入巨量海水与磷虾,再用鲸须过滤、胃部消化。对应到技术领域,就是系统需要面对:
- 非结构化/半结构化输入洪流:日志、点击流、传感器数据、消息队列……
- 瞬间峰值吞吐:突发流量可达常态数十倍。
- 不丢数据且可低成本存储:先原样“吞下”,再慢慢处理。
传统数据库往往在这个过程中成为瓶颈,而“大胃鲸鱼技术”强调分层消化:接入层扛住“吞”的压力,处理层负责“胃动力”,存储层完成“能量转化”。
二、核心分層与技术组件
因为用户的提示中文关键词为“鲸鱼胃_上传的图片 大胃鲸鱼技术”,这说明至少在实践层面,“鲸鱼胃”可能指的是用户上传的图片素材来源,但不影响我们归纳具体技术。如下四层最为关键:
1. 入口大嘴层 — 接入与缓冲
Apache Kafka、Pulsar、AWS Kinesis。像鲸鱼嘴巴一样,一秒钟吞纳数十兆消息,全凭分布式Commit Log实现堆积与并行读取。
2. 过滤与预消化 — Flink / Spark Streaming
对齐时间窗口、处理乱序事件、进行MapReduce式提炼与指标计算。有了这层,存入“胃壁”的就不再是原文水平。
3. 多次腹式反响 "胃+鳃支撑" — OLAP即库
ClickHouse、Doris、StarRocks 支持百列宽表的秒级分析。鱼与虾,如用户的画像细项簇可以被清洗反扣到卷页。
4. 慢路径储存
大规模生食配卤,来自图元消息数据整理引入 MinIO/Object Store、Iceberg/Hudi 等数据湖操作。这是更接近长时间贮存的一环。
三、大胃鲸鱼架构的主要特质
如若转载,请注明出处:http://www.daweijingyu.com/product/53.html
更新时间:2026-10-09 19:17:13